
Los editores web podrán decir «no» al entrenamiento de la IA con una sola línea en su robots.txt, en lugar de perseguir a cada rastreador por separado. Google, Microsoft y OpenAI anunciaron el 30 de octubre que respetarán una señal común para excluir contenidos del entrenamiento de modelos generativos, propuesta por Anthropic, que ya ha empezado a implementarla. Microsoft va más allá: separa el entrenamiento del uso de contenidos en las respuestas de su IA y jubila las etiquetas NoArchive y NoCache, con fechas que obligan a revisar la configuración.
Cómo funciona la nueva regla
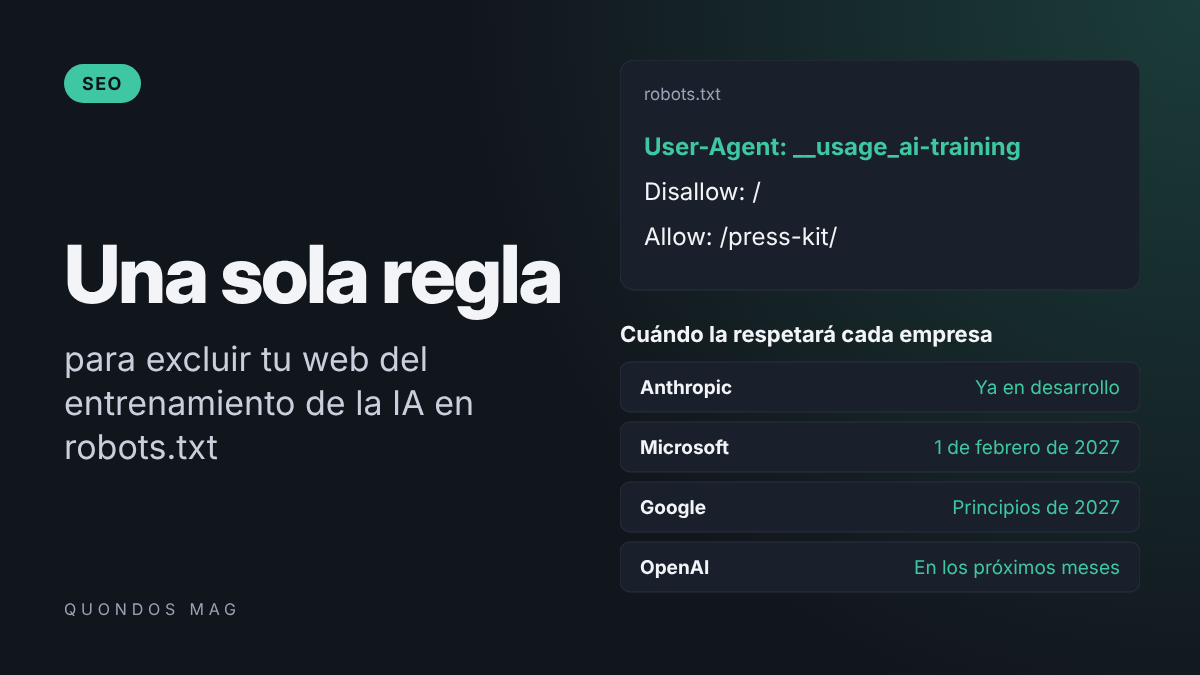
La propuesta es un borrador presentado en el IETF, el organismo que define estándares de internet, por Kevin Kelley, responsable técnico de estándares de Anthropic. Es una propuesta individual, no un estándar aprobado. No añade directivas nuevas: el sitio escribe un grupo normal de robots.txt bajo el token __usage_ai-training en la línea User-Agent, con sus reglas Allow y Disallow.
El ejemplo que recoge Engadget es sencillo: un «Disallow: /» bajo ese token excluye toda la web del entrenamiento, y un «Allow: /press-kit/» deja fuera de esa exclusión una sección concreta, como la sala de prensa. Según Search Engine Journal, un grupo comodín User-Agent: * no cuenta como preferencia para este token, y un robots.txt sin ese grupo no expresa ninguna preferencia.
La señal tiene límites claros. No bloquea el rastreo ni saca contenidos de Google Search, solo se refiere al uso de contenidos para modificar los parámetros de un modelo generativo y, como subraya Engadget, no puede deshacer lo que ya se haya recopilado: solo afecta a lo que se rastree a partir de ahora.
Cada empresa, con su calendario
Ninguna de las tres grandes lo aplica todavía. Google lo anunció en su blog de Search Central de la mano de John Mueller y pretende darle soporte en 2027; su documentación habla de principios de año. Si una web usa la exclusión común y no menciona Google-Extended, Google la tratará como si hubiera bloqueado Google-Extended, el control que ya ofrecía desde 2023.
Ese detalle importa. Según Search Engine Journal, Google-Extended no solo cubre el entrenamiento de futuros modelos de Gemini, sino también el uso de contenidos para fundamentar respuestas en la app de Gemini y en Vertex AI. Es decir, con Google no se puede bloquear el entrenamiento y a la vez permitir esa fundamentación. Lo que sí deja claro es que no afecta a la inclusión en Google Search.
OpenAI se ha comprometido a respetar la señal «en los próximos meses» y mantiene mientras tanto sus controles actuales, como GPTBot, aunque no aclara qué pasará si ambas reglas se contradicen. Microsoft empezará el 1 de febrero de 2027.
Microsoft separa entrenamiento y respuestas, y jubila NoArchive
Microsoft ha publicado el cambio más ambicioso. Según su blog de Bing, firmado por Krishna Madhavan, además del entrenamiento habrá una preferencia de AI Grounding, que decide si una página puede usarse como base de las respuestas de Bing, Copilot y Microsoft 365. Se fija página a página con una etiqueta meta o una cabecera HTTP, y tiene tres opciones: permitir, que es lo predeterminado, bloquear o una vía intermedia, DisallowExtended, que permite sus propios productos pero no los servicios de grounding que vende a terceros.
Estas preferencias sustituyen a NoArchive y NoCache, las etiquetas que Microsoft introdujo en 2023. El calendario es estricto: el 15 de diciembre se abrirá en Bing Webmaster Tools una preferencia temporal para quien las use; el 1 de febrero de 2027 Microsoft empezará a aplicar las nuevas; y desde el 1 de marzo de 2027 las etiquetas antiguas dejarán de valer para entrenamiento y grounding. La compañía avisa de que bloquear el grounding reducirá la visibilidad de la marca en sus experiencias de IA, y de que ninguna opción garantiza inclusión, tráfico ni pago.
Qué deberían hacer los profesionales del SEO
Lo primero es no tocar nada sin una decisión de negocio detrás. Bloquear el entrenamiento no afecta al posicionamiento en Google ni en Bing, pero con Google también implica salir de la fundamentación de Gemini, y en Bing el grounding es lo que da visibilidad en Copilot. Cada web debe decidir qué quiere proteger y qué visibilidad está dispuesta a perder.
Lo urgente es para quien use NoArchive o NoCache para frenar a Copilot: tiene hasta el 1 de marzo de 2027 para publicar las nuevas preferencias. Y para el resto, es buen momento para auditar el robots.txt, documentar qué reglas hay para cada rastreador de IA y preparar el grupo __usage_ai-training si se quiere excluir el entrenamiento, sabiendo que Google y OpenAI aún no lo aplican.