
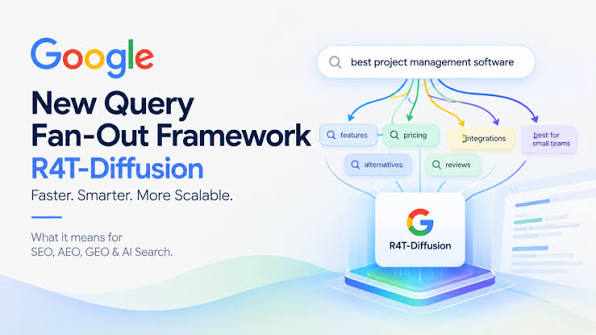
Google ha presentado R4T-Diffusion, un nuevo framework diseñado para generar query fan-outs de mayor calidad con menos coste computacional y menor latencia. La tecnología busca resolver uno de los problemas asociados a las nuevas experiencias de búsqueda basadas en inteligencia artificial: la necesidad de transformar una consulta amplia del usuario en múltiples búsquedas más específicas que permitan recuperar información relevante.
El sistema, denominado Retrieve-for-Train-Diffusion, combina aprendizaje por refuerzo, generación de datos sintéticos y un modelo de difusión generativo de tamaño reducido. Según la información publicada por Search Engine Journal a partir del anuncio de Google y del trabajo de investigación asociado, el modelo cuenta con 53,9 millones de parámetros.
Qué es el query fan-out y por qué importa
El concepto de query fan-out hace referencia a la generación de múltiples consultas a partir de una petición original. En lugar de intentar responder directamente a una pregunta amplia, un sistema puede dividirla en diferentes búsquedas relacionadas para obtener información desde distintos ángulos.
Esta técnica puede resultar especialmente útil para los sistemas de búsqueda basados en IA, ya que una consulta compleja puede requerir información procedente de diferentes fuentes o conjuntos de datos. El problema es que generar muchas consultas mediante modelos grandes puede aumentar considerablemente el tiempo de respuesta y el coste computacional.
R4T-Diffusion intenta solucionar ese problema mediante un modelo mucho más pequeño que aprende a reproducir determinados comportamientos de modelos de mayor tamaño. Google utiliza para ello una estrategia de destilación de conocimiento.
Google entrena un modelo pequeño con el comportamiento de otro mayor
El proceso comienza entrenando un modelo para aprender cómo generar query fan-outs de alta calidad. El sistema produce ejemplos de diferentes resultados y conserva aquellos que cumplen determinados criterios. Posteriormente, esos ejemplos se utilizan para entrenar el modelo de difusión de 53,9 millones de parámetros.
La idea es trasladar parte del comportamiento aprendido por un sistema computacionalmente más costoso a un modelo más pequeño. De esta manera, el modelo final puede realizar la tarea sin necesitar el mismo nivel de recursos durante la fase de inferencia.
Google explica que el nuevo sistema está optimizado para generar consultas que mantengan una relación clara con la petición original. Al mismo tiempo, intenta evitar que todas las consultas generadas sean simplemente sinónimos redundantes de la pregunta inicial.
Tres criterios para mejorar las consultas generadas
El entrenamiento de R4T utiliza una combinación de tres objetivos. El primero es la groundedness, que busca garantizar que las subconsultas generadas correspondan con elementos que puedan recuperarse realmente de la base de datos.
El segundo criterio es la diversidad. Google utiliza una métrica denominada Vendi Score para favorecer conjuntos de subconsultas con amplitud semántica. La intención es evitar que el sistema genere muchas consultas prácticamente idénticas y conseguir que explore diferentes partes del espacio de información.
El tercer elemento es el alignment, que mantiene las subconsultas vinculadas a la intención de la petición original. De esta forma, el sistema intenta conseguir diversidad sin alejarse demasiado del significado de la consulta inicial.
R4T-Diffusion busca reducir drásticamente la latencia
Uno de los principales argumentos de Google para este nuevo sistema es la velocidad. La compañía asegura que el modelo de difusión puede generar todas las direcciones objetivo en un único proceso paralelo no autoregresivo dentro del espacio continuo de embeddings.
Según los datos publicados por Google, este enfoque proporciona una mejora de entre 12 y 20 veces en velocidad frente a determinados métodos autoregresivos. En escenarios de grandes lotes de contexto, Google explica que la latencia de los métodos anteriores podía acercarse a los 50 segundos.
R4T-Diffusion, en cambio, se mantiene entre menos de un segundo y unos pocos segundos en las condiciones descritas por Google. La compañía utiliza estos resultados para presentar el framework como una solución preparada para aplicaciones de búsqueda a gran escala.
El objetivo no es únicamente reducir el tiempo de respuesta. La reducción del coste computacional también puede facilitar que los sistemas generen más consultas secundarias por cada petición sin que el proceso se vuelva demasiado caro.
El framework puede utilizarse también fuera de la búsqueda
Aunque el query fan-out es la aplicación más evidente, los investigadores señalan que R4T puede utilizarse en otros sistemas que necesiten recuperar información de diferentes formas. Entre las posibilidades citadas aparecen los sistemas de recomendación, el creative search y otros escenarios de acceso exploratorio a información.
Esto resulta relevante porque los sistemas de recomendación también necesitan generar y seleccionar diferentes direcciones posibles. La investigación menciona aplicaciones como Google Discover y las recomendaciones de YouTube como ejemplos del tipo de sistemas que pueden beneficiarse de técnicas de recuperación más diversas.
Los investigadores también señalan que el framework podría extenderse a tareas como planificación y generación creativa. La característica común es la necesidad de producir diferentes posibilidades manteniendo determinados criterios de relevancia, cobertura y diversidad.
Google todavía no confirma que R4T ya esté integrado en Search
Uno de los aspectos que permanece abierto es si R4T-Diffusion ya está desplegado en el buscador de Google. Search Engine Journal señala que el anuncio describe el sistema como preparado para producción, pero eso no equivale necesariamente a confirmar su utilización dentro del buscador público.
La publicación también recoge observaciones de profesionales del sector que han detectado cambios en tráfico o en el número de enlaces mostrados en determinadas experiencias de IA. Sin embargo, esas observaciones no permiten demostrar que R4T-Diffusion sea la causa de esos cambios.
Además, los propios investigadores introducen advertencias sobre el uso del sistema en contextos sensibles. La investigación señala la necesidad de realizar auditorías de sesgos específicas por dominio, diseño inclusivo y mecanismos de supervisión. El framework se presenta así como una herramienta de recuperación escalable, pero no como sustituto de la supervisión humana.
R4T-Diffusion representa, en cualquier caso, un avance técnico en la búsqueda basada en IA: generar consultas secundarias más diversas y relevantes sin asumir el coste de ejecutar constantemente modelos grandes. Si este tipo de arquitectura se integra progresivamente en productos de búsqueda y recomendación, la forma en que los sistemas descomponen las consultas podría convertirse en un componente cada vez más importante de la experiencia de búsqueda.