
Odyssey ha presentado Odyssey-3, un nuevo modelo fundacional del mundo diseñado para comprender y simular cómo funciona el entorno físico y virtual. Según la compañía, el sistema puede utilizarse como base para controlar robots, humanoides, vehículos y drones, además de entrenar otras inteligencias artificiales y ejecutar tareas en videojuegos.
La propuesta parte de una idea que Odyssey lleva desarrollando desde su fundación en 2023: crear modelos capaces de aprender física, movimiento, relaciones causa-efecto y comportamiento humano a partir de grandes cantidades de observaciones visuales. La compañía sostiene que este conocimiento permite reducir la cantidad de datos específicos necesarios para enseñar posteriormente una tarea concreta.
Odyssey-3 ha sido presentado el 15 de septiembre de 2026 por Oliver Cameron y Jeff Hawke, cofundadores de la empresa. De acuerdo con Odyssey, se trata de su modelo fundacional del mundo más avanzado hasta la fecha y de uno de sus primeros ejemplos de una inteligencia aprendida que puede trasladarse entre distintos sistemas físicos y virtuales.
Un modelo del mundo pensado para diferentes máquinas
Odyssey-3 está construido como un transformer de difusión autorregresivo entrenado para simular escenarios muy diversos. La compañía explica que su entrenamiento se basa en una gran colección de observaciones visuales del mundo, con las que el modelo aprende representaciones relacionadas con la física, la dinámica y las interacciones entre personas y objetos.
La diferencia respecto a sistemas especializados está, según Odyssey, en que el conocimiento adquirido durante el preentrenamiento puede reutilizarse en nuevas aplicaciones. En lugar de comenzar desde cero para cada máquina o tarea, un mismo modelo puede servir como base para distintas políticas de control adaptadas posteriormente a cada sistema.
Para convertir ese conocimiento interno en acciones concretas, Odyssey utiliza un componente denominado action decoder. Este elemento aprende a relacionar las representaciones generadas por el modelo con los controles necesarios para manejar un robot, un coche, un dron u otro sistema.
La compañía afirma que sus primeros experimentos muestran resultados utilizando solo unas pocas horas de datos de experiencia en determinadas aplicaciones. La cantidad exacta depende del sistema y de la tarea, pero la idea común es aprovechar el conocimiento adquirido previamente para reducir el volumen de datos específico que necesita cada nuevo entrenamiento.
Odyssey-3 ya se ha probado con brazos robóticos
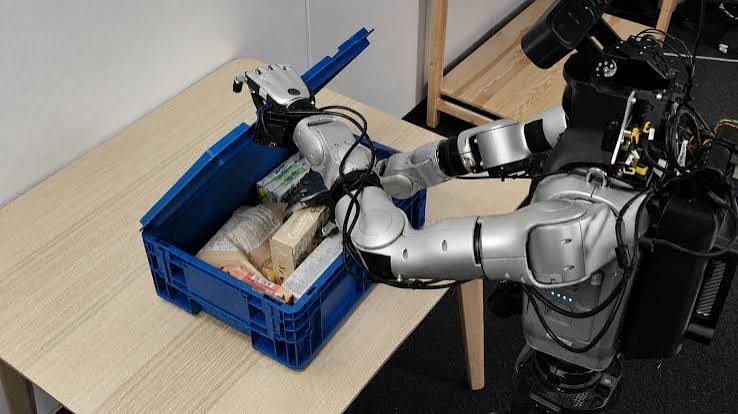
Uno de los primeros escenarios mostrados por Odyssey es el control de brazos robóticos. Según los experimentos de la compañía, el modelo puede aprender a manejar diferentes brazos con decenas de horas de demostraciones y completar tareas que requieren varias acciones consecutivas.
Uno de los aspectos destacados por Odyssey son determinados comportamientos de recuperación que no aparecían en las demostraciones utilizadas durante el entrenamiento. Entre los ejemplos citados están volver a orientar una pinza después de fallar un agarre o recuperar un objeto que ha caído en una posición o una orientación poco habitual.
Para comprobar hasta qué punto estas capacidades se mantienen al cambiar de máquina, cuerpo o perspectiva, Odyssey ha anunciado una colaboración con Poke & Wiggle. El objetivo es evaluar el modelo en diferentes robots, puntos de vista y sistemas de control, además de identificar los casos en los que el conocimiento aprendido deja de transferirse correctamente.
Esta cuestión resulta especialmente relevante para la robótica porque recoger demostraciones de cada posible fallo y situación de recuperación puede resultar costoso. La propuesta de Odyssey consiste precisamente en que una parte de ese conocimiento pueda proceder del modelo general del mundo y no exclusivamente de ejemplos específicos de cada robot.
Flexion utiliza Odyssey-3 como base para robots humanoides
Odyssey también ha anunciado una colaboración de investigación con Flexion, especializada en inteligencia robótica, reinforcement learning y control de cuerpo completo. En este caso, Odyssey-3 actúa como modelo base sobre el que Flexion desarrolla sus propias políticas de control para robots humanoides.
Según la información facilitada por Odyssey, el sistema desarrollado por Flexion puede realizar tareas en tiempo real utilizando decenas de horas de datos de teleoperación humanoide. El trabajo combina las representaciones previamente aprendidas por Odyssey-3 con las técnicas de aprendizaje y control desarrolladas por Flexion.
En las evaluaciones descritas por la compañía, las políticas humanoides mantuvieron determinadas tareas cuando cambiaron las condiciones de iluminación. Odyssey señala que, en esas pruebas, los sistemas desarrollados sobre su modelo continuaron ejecutando las tareas en situaciones en las que las referencias VLA utilizadas como comparación dejaron de hacerlo.
La colaboración pretende explorar precisamente cuánto conocimiento físico puede aportar un modelo general antes de que el robot reciba entrenamiento específico. Para Odyssey, esto abre una vía hacia robots capaces de aprender habilidades nuevas con menos demostraciones y adaptarse a cambios del entorno.
También puede conducir un coche con datos simulados
Otro de los experimentos presentados se centra en la conducción autónoma. Odyssey asegura que Odyssey-3 puede conducir un vehículo en un entorno cerrado utilizando 20 horas de datos de conducción simulada. El sistema genera trayectorias en tiempo real mientras el modelo del mundo permanece congelado durante el entrenamiento.
En este planteamiento, una política de conducción relativamente pequeña utiliza las representaciones visuales proporcionadas por Odyssey-3 para predecir los puntos de referencia que debe seguir el vehículo. La experiencia simulada sirve para aprender cómo aplicar el conocimiento del mundo a la conducción, en lugar de tener que aprender desde cero cómo funciona el entorno.
Odyssey comparó políticas entrenadas exclusivamente mediante simulación con otras entrenadas utilizando imágenes de conducción real. Las pruebas se realizaron en carreteras con tráfico y diferentes distracciones, incluyendo curvas, vehículos adelantando por ambos lados y giros en intersecciones concurridas.
Según los datos publicados por la empresa, en carreteras reales las políticas entrenadas completamente en simulación recorrieron aproximadamente un 77 % de la distancia entre intervenciones del conductor de seguridad que las políticas entrenadas con imágenes de conducción real. La cifra corresponde específicamente al experimento descrito por Odyssey.
El mismo enfoque llega a los drones
Odyssey-3 también se ha utilizado para desarrollar una política de navegación aérea. En este caso, el sistema recibe observaciones recientes de la cámara, el estado de movimiento del dron y una instrucción de navegación para generar los puntos de trayectoria que debe seguir.
La política utiliza las representaciones visuales previamente aprendidas por Odyssey-3 y recibe posteriormente ejemplos de vuelo simulado. Odyssey afirma que, con decenas de horas de datos simulados, consiguió entrenar una política capaz de mantener un vuelo estable y evitar obstáculos en un entorno interior simulado.
La compañía también analizó qué conocimientos aparecían ya en el modelo antes del entrenamiento específico de navegación. Para ello mantuvo congelados sus pesos y observó sus predicciones en diferentes situaciones aéreas, donde encontró respuestas compatibles con dirección, movimiento y obstáculos.
Estos experimentos son importantes dentro del planteamiento de Odyssey porque muestran cómo un único modelo puede proporcionar representaciones reutilizables para sistemas con características muy diferentes. Un coche y un dron tienen controles distintos, pero ambos necesitan interpretar espacio, movimiento y relaciones físicas.
Odyssey-3 también puede generar mundos para entrenar otras IA
Una de las aplicaciones más diferentes respecto a la robótica es el entrenamiento de otras inteligencias artificiales. Odyssey-3 puede generar entornos en los que los agentes de IA interactúan, realizan acciones y observan las consecuencias de sus decisiones.
La compañía está explorando este planteamiento mediante PROWL, un trabajo en el que los agentes pueden descubrir fallos que posteriormente sirven para mejorar el modelo del mundo. Al mismo tiempo, las experiencias simuladas que genera el modelo pueden utilizarse para entrenar a esos propios agentes.
El planteamiento crea un ciclo en el que el modelo y los agentes se retroalimentan. A medida que el mundo simulado mejora, puede ofrecer experiencias más complejas; y cuando los agentes adquieren nuevas capacidades, pueden encontrar problemas que sistemas menos avanzados no llegarían a detectar.
Odyssey también señala otra utilidad para estos entornos virtuales: permitir estudiar el comportamiento de sistemas cada vez más capaces antes de que determinadas conductas puedan producirse en el mundo físico. Según la compañía, los mundos simulados pueden servir para investigar comportamientos potencialmente peligrosos y sus consecuencias en un entorno controlado.
El modelo también ha llegado a los videojuegos
Los videojuegos ofrecen otro escenario para comprobar si el conocimiento aprendido puede trasladarse entre entornos. Odyssey ha entrenado políticas utilizando grabaciones de partidas asociadas a controles de teclado y ratón, mientras mantiene congelado el modelo del mundo previamente entrenado.
Los experimentos incluyen sesiones prolongadas en GTA V, con ejemplos de conducción, disparos y combate cuerpo a cuerpo. Según Odyssey, el sistema también ha mostrado señales iniciales de transferencia hacia otros videojuegos sin entrenamiento adicional específico para esos títulos.
Uno de los ejemplos citados por la empresa utiliza aproximadamente dos horas de imágenes de GTA V para entrenar una política de movilidad. Posteriormente, esa política consiguió producir movimientos a caballo en Red Dead Redemption 2, pese a que el personaje, el vehículo y el entorno eran diferentes.
Odyssey también señala resultados iniciales en Sleeping Dogs, donde políticas entrenadas en GTA V pudieron utilizarse para conducir una motocicleta sin entrenamiento adicional en ese juego. Para la compañía, estos experimentos sirven como indicio de que algunas habilidades aprendidas pueden transferirse entre cuerpos, entornos y sistemas de control diferentes.
Odyssey plantea una nueva generación de agentes físicos
La visión de Odyssey parte de comparar la forma en que los humanos aprenden con la manera en que muchos robots actuales adquieren habilidades. Según la compañía, los humanos aprovechan conocimientos previos sobre objetos, movimiento, espacio, herramientas y consecuencias físicas cuando afrontan una tarea nueva.
En cambio, muchos sistemas robóticos dependen todavía de grandes cantidades de demostraciones específicas. Odyssey considera que los modelos del mundo pueden reducir esa dependencia al proporcionar previamente una representación general de cómo funciona el entorno y permitir que las nuevas habilidades se aprendan sobre esa base.
La empresa utiliza el término physical agents para describir sistemas capaces de interactuar directamente con el mundo físico y virtual. Odyssey-3 pretende servir como una capa común para robots, humanoides, coches, drones y agentes capaces de desenvolverse en videojuegos.
La compañía plantea posibles aplicaciones futuras en automatización de tareas físicas, investigación científica e ingeniería, además de situaciones en las que las personas necesitan asistencia para realizar determinadas actividades. Estas son posibles aplicaciones planteadas por Odyssey, no capacidades comerciales generales que el comunicado presente como disponibles actualmente.
Otro aspecto destacado por Odyssey es la relación entre los modelos del mundo y los sistemas de inteligencia artificial que aprenden dentro de ellos. La compañía plantea que modelos más capaces pueden generar experiencias más complejas, mientras que los agentes que interactúan con esas experiencias pueden descubrir nuevos problemas y aportar información para seguir mejorando los propios modelos.
Odyssey-3 llegará públicamente en las próximas semanas
Por ahora, Odyssey-3 ha sido presentado principalmente mediante los experimentos y resultados compartidos por la propia compañía. Esto significa que las cifras descritas, como las 20 horas de datos simulados para conducción o las decenas de horas utilizadas en robótica y drones, deben entenderse dentro de las condiciones concretas de las pruebas comunicadas.
Odyssey afirma que sus resultados representan señales iniciales de lo que pueden ofrecer los modelos generales del mundo. La empresa también reconoce que todavía es necesario estudiar dónde se transfiere el conocimiento y dónde aparecen limitaciones, especialmente al cambiar de robots, entornos, perspectivas o controles.
El siguiente paso anunciado es la publicación de Odyssey-3 en las próximas semanas. La llegada pública permitirá conocer con mayor detalle cómo se puede utilizar el modelo y hasta qué punto los resultados mostrados en los experimentos de la compañía pueden reproducirse en nuevos escenarios.
Con Odyssey-3, la empresa busca llevar los modelos del mundo más allá de la simulación visual y convertirlos en una base para sistemas capaces de percibir, aprender y actuar en entornos físicos y virtuales. El alcance real de esta propuesta dependerá de su disponibilidad pública y de las evaluaciones que se realicen fuera de los experimentos presentados por Odyssey.
Fuente: https://odyssey.systems/introducing-odyssey-3